Lecture 10: Actor-Critic Methods
强化学习中的数学原理 | 第十课

Actor-critic methods are still policy gradient methods.
actor指 policy update. It’s called actor is because the policy will be applied to take actions.critic指 policy evaluation / value evaluation. It is called critic because it criticizes the policy by evaluating it.
- A scalar metric
, which can be or - 梯度下降最大化
的算法:
- 随机梯度下降算法(把上面梯度的期望变成一个随机采样的梯度):
这个算法里我们就能看到actor和critic!
- 这个算法本身就是一个
actor,他在更新策略的参数,也就是更新策略 - 关注这个算法里的
,他是 的估计,估计的算法就是 critic
所以我们该怎么得到
目前我们学了两种方法来估计action values:
- 蒙特卡洛法:REINFORCE(a.k.a. Monte Carlo policy gradient)
- 时序差分法(Temporal-difference learning): 使用TD来估计时,这个算法就叫
actor-critic
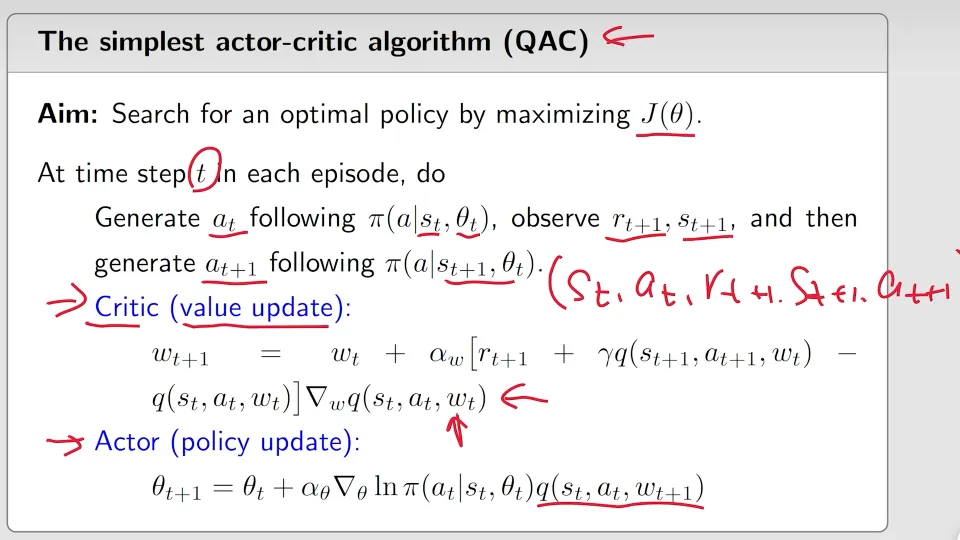
解读:
-
在第t个时间步:
- 根据策略
生成 ,跟环境交互得到 ,然后根据 生成
发现我们拥有了
,我们就可以把他们放到一个算法中去估计action value - 然后critic算法就是函数近似(value function approximation)版本的
SARSA算法(State-Action-Reward-State-Action TD那一章学的) 得到更新了以后,就去更新 ,得到了新的策略,新的策略就用于下一个时间步
- 根据策略
A2C 是 QAC 的推广
他的基本思想是引入一个baseline来减少方差
首先介绍一个性质,我们所推导的policy gradient这个梯度
我稍微有点迷失方向了,我们回顾一下我们现在在干什么
目标函数
我们要
为了做梯度上升,所以我们要求
前面的梯度策略定理学到:
含义:拿每一条样本,用
所以后面我们就引入了一个baseline,减到
这里baseline
接下来要回答两个问题:
- 为什么引入这个新的
函数不会造成影响(不改变期望) - 为什么我们要关心这个
函数,他有什么作用(能降低方差)
First,引入
详细推导:
Second,我们要考虑这个baseline到底有什么用
复述一下我们前面的目标函数是
和 没有关系 和 有关系
关于对于方差的影响的数学推导不详细说明
不过我们就可以把目标定为找到最优的baseline来最小化
最好的baseline是:
证明省略,并且虽然这是最优的,但是他太复杂了,所以一般我们把他的权重(
发现就是
我们把前面讨论的
advantage function,大家也常用
why called advantage?
与平均的差值自然称的上是advantage
上面是期望的形式,我们自然也能想到给出随机梯度的形式:
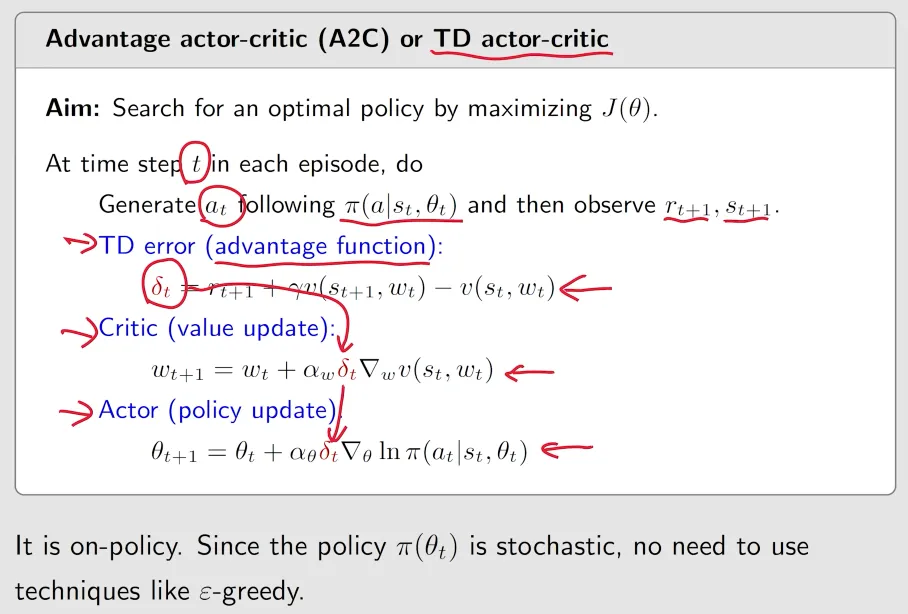
进一步,我们可以把算法重写成
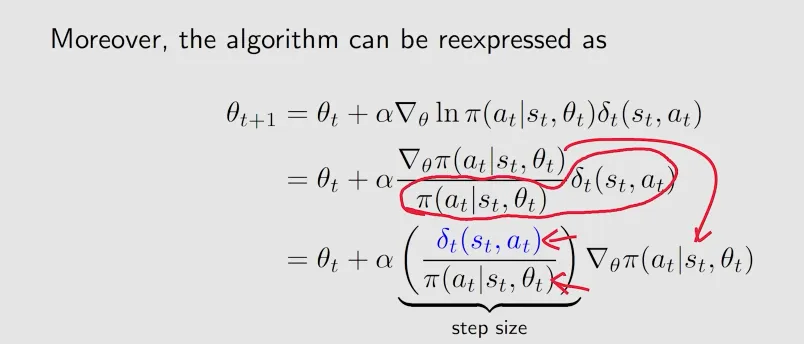
这个形式在上一节策略梯度算法里也有类似的,当时
-
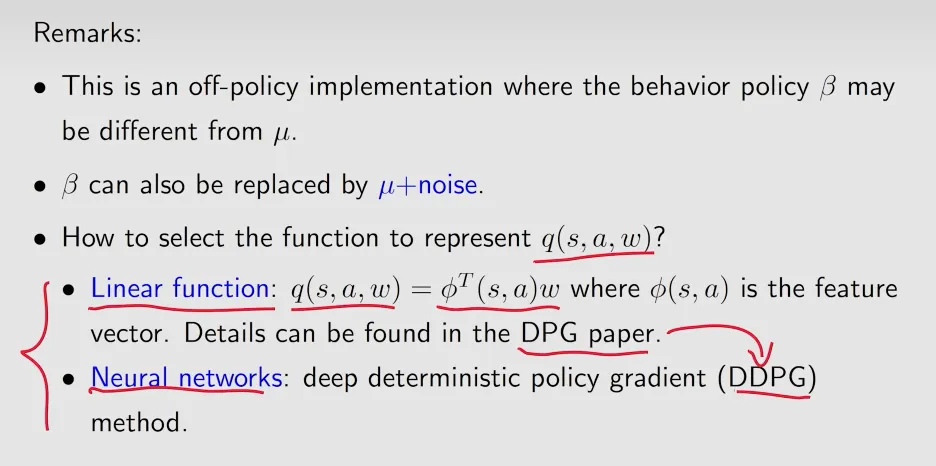
Policy gradient is on-policy 因为梯度是
,采样的数据是服从 的,且要更新的策略也是 目前
actor-critic和policy-gradient的方法都是on-policy的 -
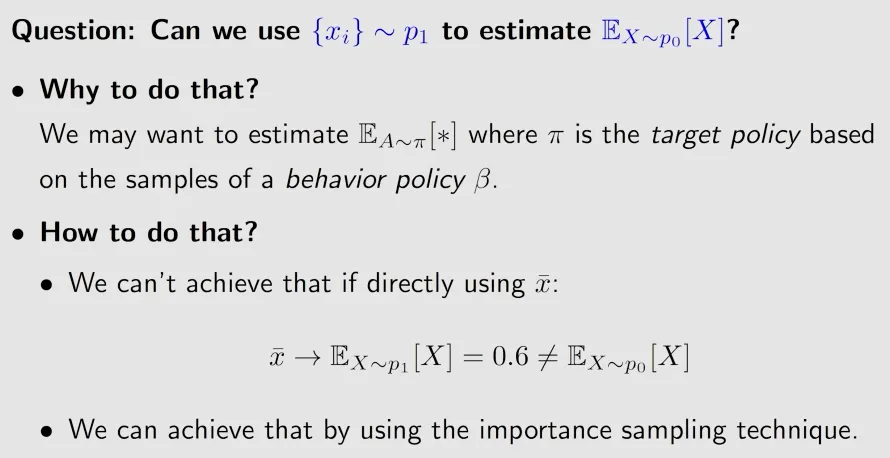
如果我们之前有一些off-policy的方法,我们想用这些经验,我们就像把on-policy的算法转换成off-policy的方法
- 使用的方法是
重要性采样 important sampling - 重要性采样不是专属于AC算法的,任何要求期望的算法都能用
- 使用的方法是
下面开始介绍important sampling 重要性采样
学完后回过头来复习,我先梳理一下重要性采样是什么
核心目的:用一个分布的样本,去估计另一个分布下的期望
这个方法名为重要性采样的原因是:
- 原本我们要算期望,直接采样就好,但现在遇到了可以采样但无法准确估计期望的情况
- 所以我们换一个分布来采样:专门多采
重要的地方,多采是从权重上体现的
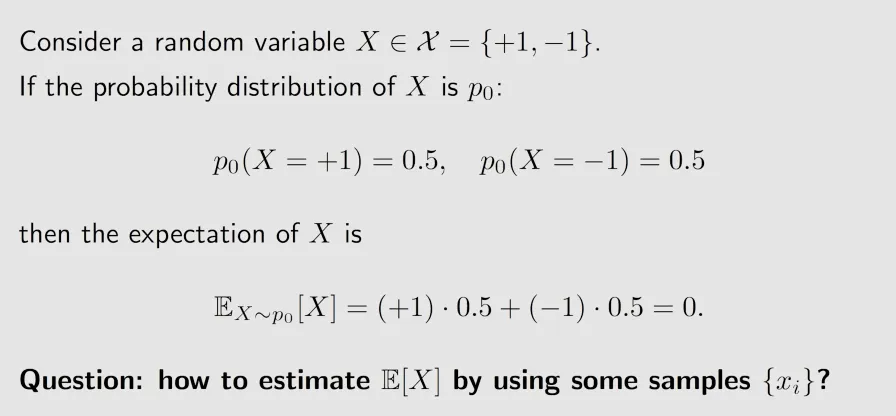
Question: 如何通过采样
方法一:
蒙特卡洛法
because
方法二(我们要学的新方法):
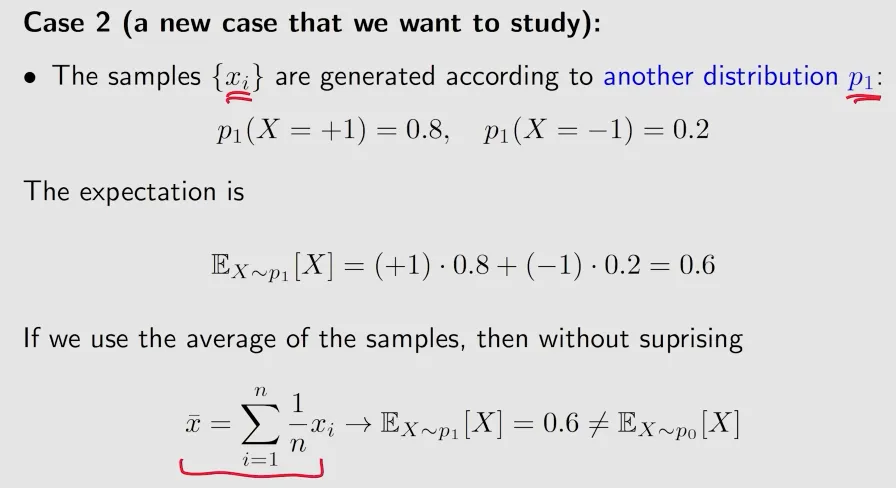
我们要求的最终目标:
- 因此,我们可以通过估计
来估计 - 如何估计
?
Let
Then, 大数定理:
因此,
- 依旧是对
求平均,不过是加权平均,权重是 ,叫做 important weight- if
,采样分布就是目标分布,不需要权重修正 - if
,说明采样的时候是 ,但真实 却是大的,所以权重把在期望里的占比拉大
- if
你一定会疑惑的问题:上面的计算里涉及到
因为这里我们遇到的情况是,给到一个
例如:连续的分布在求期望时要用到积分,而函数是一个神经网络,没有表达式,自然就求不了期望
如果遇到的情况是能求期望,那么不需要用这个重要性采样的方法,直接算就好
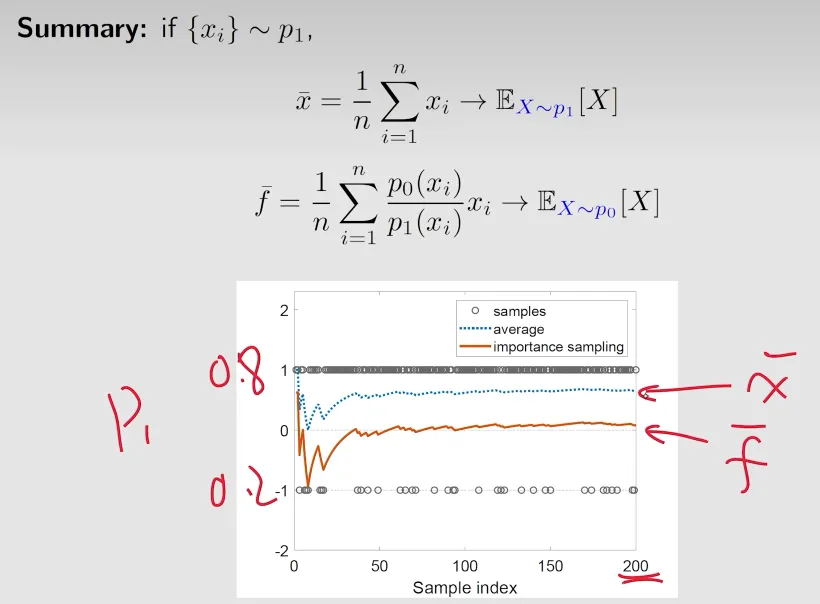
我们把重要性采样应用到策略梯度算法中,去实现off-policy的学习,首先我们要得到gradient的表达式,下一小节我们会把他应用到梯度上升的方法中进行优化
梯度长什么样子:
- 假设
是生成经验采样的 behavior policy - 我们的目标是优化
, 是 target policy 的参数
where
直接给出这个目标函数对应的gradient,细节省略:
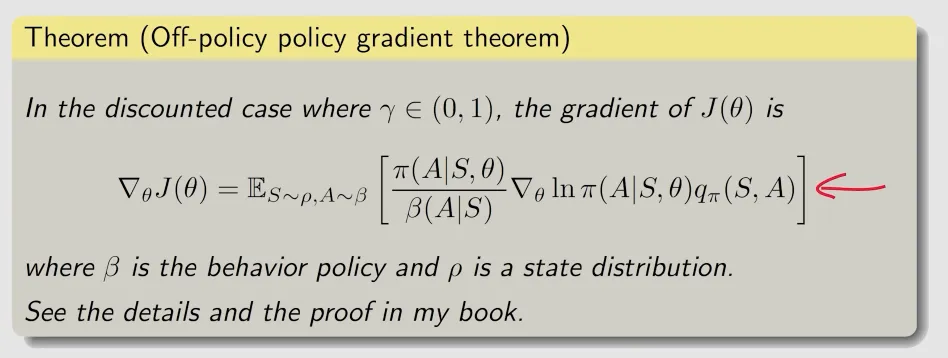
- on-policy的时候
,现在 是重要性采样的权重, 是 , 是
off-policy policy gradient 依旧可以引入一个baseline
- 为了减小方差,以及尽量不太复杂,我们常把baseline设为
然后把梯度的公式代入随机梯度下降算法:
和之前的A2C算法中一样,TD error:
因此,算法公式写成:
进一步用对数求梯度的那个公式来转化成:
比较大的时候是充分利用 - 之前分母上是
,这时 比较小的时候就起到探索的作用,但是这里是 ,所以探索就没有了,体现了这是 off-policy的
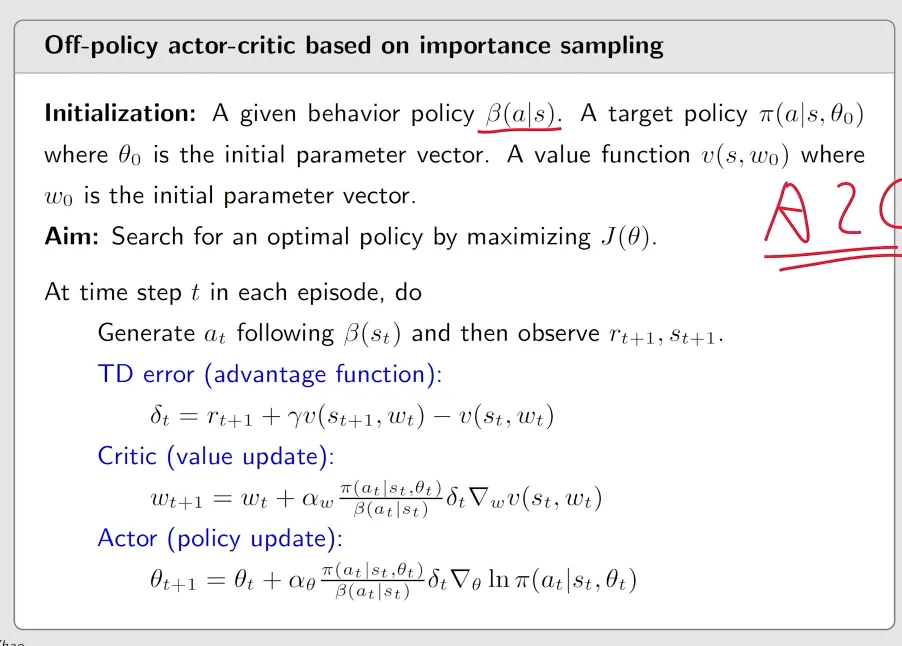
回顾一下
- 介绍
QAC时:突出actor-critic的思想 - 介绍
A2C时:引入baseline来减少估计都方差 - 介绍
off-policy actor-critic:引入重要性采样这个方法
前面3节的特点是
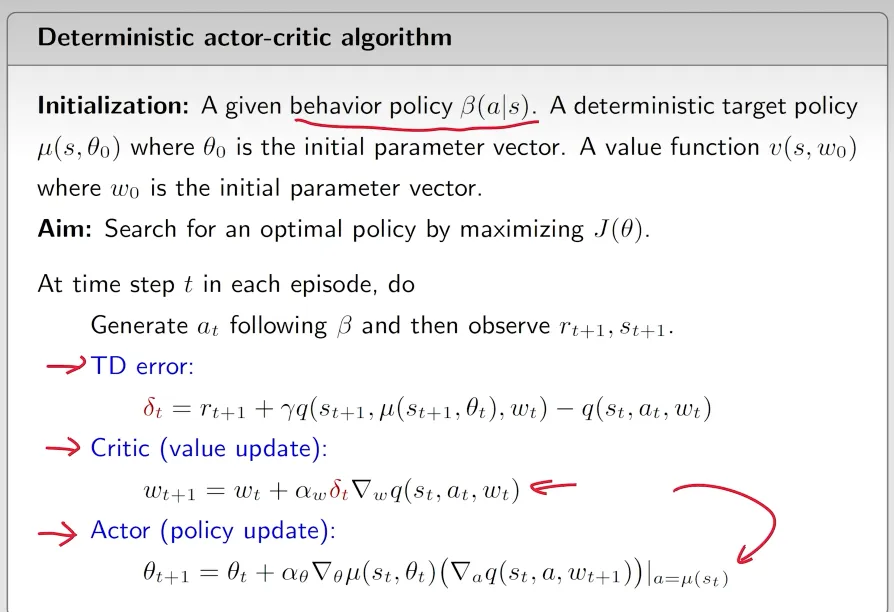
下面我们要介绍的则是确定的 deterministic actor-critic,指每个状态下一定有一个动作的概率是1
为什么我们要关心deterministic?
因为策略是随机的时,所有action都有可能,但是当action的个数是无限个时,就不好搞,这是就需要 deterministic
什么是 deterministic policy
, is a mapping from to 可以是一个神经网络 - 可以把
简写成
接下来先介绍梯度怎么计算,第二步把梯度运用到梯度上升的方法中进行优化
首先有一个目标函数,这个例子里,metric是state value的期望
is independent of
梯度的1公式直接给出,推导省略:
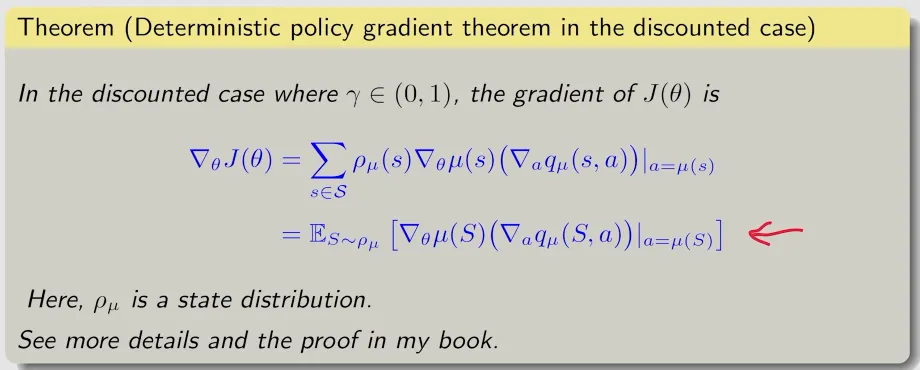
- 这个梯度和前面的随机的,是非常不一样的
- 随机策略时,对每个状态,动作是随机采样出来的,梯度里要对动作a求期望
- 而这里是确定性策略,给定状态s,动作直接唯一确定,没有动作的概率分布
- DPG期望只需要状态的分布
,不需要目的确定性策略 去生成样本
有了梯度之后,应用到梯度上升的方法中进行优化:
然后使用随机梯度: