Lecture 8: Value Function Approximation
强化学习中的数学原理 | 第八课 | 待完善

学这一章主要是很想学 DQN,上学期学校的人工智能导论课里有让自学,但显然没有真正学会,我很想实际看到如何把神经网络结合进Q learning里
上一章介绍的是TD learning,这一章实际上也是TD learning,不过上一张使用的是tabular representation,而这一章我们会使用的是function representation,从表格到函数会有一个想法上的跳跃需要理解
这一章还会第一次把神经网络引入强化学习
也会讲 DQN
目前为止,我们一直都使用表格来表示state values和action values
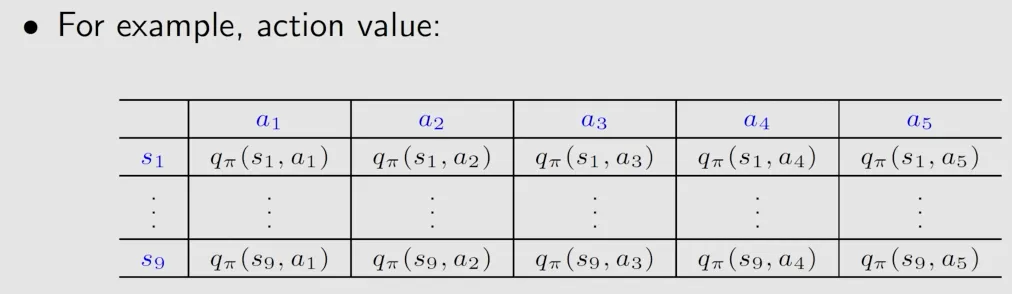
以state和action为维度的这种表格好处是很直观
但坏处是当动作和状态空间太大是不方便存储
那我们何尝不使用一个曲线把拟合所有数据,从而只需要存储曲线的参数,因为一个曲线的参数显然是比把所有数据都存储下来要少的
假设我们能用一条直线来拟合这些点,那么方程就是:
where
is the parameter vectoris the feature vector 特征向量ofis linear in (只是说这种情况)
我们可以从直线升级成second-order curve 二阶曲线:
- 尽管
是一个 的非线性函数但是对 来说是线性的,他的非线性都包含在了 里,当然,我也可以用一个神经网络来拟合,这时就是非线性的了
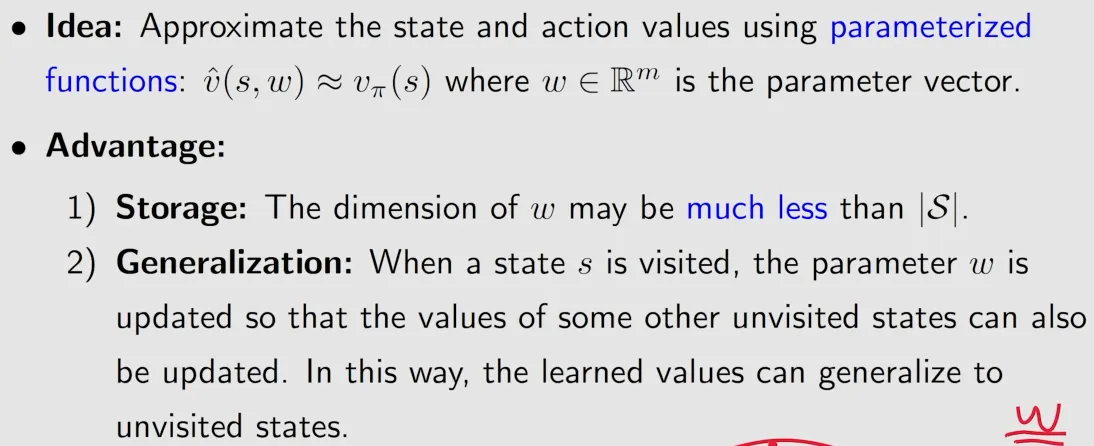
重点提到了他的泛化能力增强,因为改变参数不止会改变一个点的数值,多个点都会改变
非常重要!!!!!!!思想、概念、细节
Introduce in a more formal way:
是真的state value, 是要估计的函数 - 我们的目标就是找到最优的
让 对所有 都最拟合 - 那么这实际上就是一个policy evaluation的问题(后续我们还会涉及到如何接近他真实的state value,以及如何找到 optimal policy,后面都会讲到)
- 找 optimal
,有两步: - 定义一个 objective function 目标函数
- 优化目标函数
先直接给出目标函数是什么,这个目标函数看起来很合理
- 我们要 minimize
- 式子里的
是一个随机变量 ,那么 的概率分布是什么? - 这个问题我们之前从未遇到过
- 有很多种方法来定义
的概率分布,下面会介绍两种
The first way is to use a uniform distribution 平均分布
那么,就可以把上面的期望拆了
这是最简单的做法了,但我们肯定更希望能给一些更重要的状态更大的权重
The second way is to use the stationary distribution
- stationary distribution 平稳分布,他描述了马尔科夫过程中的一段long-run behavior(长期、稳态行为)
- Let
denote the stationary distribution of the Markov process under policy . and - 给出目标函数(这回出现概率大的情况就分到大的权重)
关于 stationary distribution 更多讲解
- 是状态的分布
- 是 long-run behavior,跑了很多步,接近平稳
- 可以叫做:steady-state distribution/limiting distribution
- 他对理解 value function approximation method 很重要
- 也对理解下章的 policy gradient method 很重要
经过长期的 long-run behavior,
我们也可以通过另一个方程来估计:
是状态转移矩阵,里面每个元素是 是 的特征向量
有了刚才的目标函数,现在我们要优化这个目标函数
- 梯度下降算法:
- 梯度公式是
把期望替换成随机梯度
where
- 这个算法实际还不能使用,因为算法里用到了true state value
,我们还不知道,因此我们要把 用一个估计替换掉
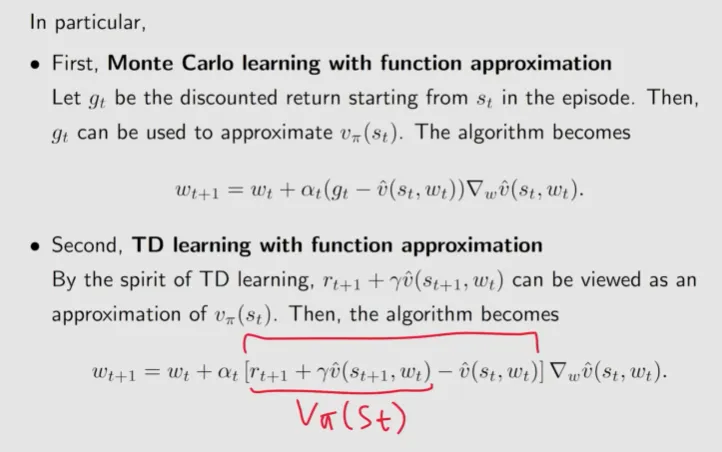
跳过了,有点看不懂
把上面讲的整体思路捋一下,我上面有些没看懂的没有记上去
- The story started from the objective function:
从一个目标函数出发,要减小估计的
- 然后就用梯度下降的公式
- 别忘了上面的
我们是不知道的,所以我们要用一个估计来替代:
这条故事线有些不严谨的地方,但先别管了
直接上 Sarsa 和 value function approximation 结合的算法
和前面那个算法的区别就是把
给出把上面的公式(policy evaluation) 和 policy improvement 结合的伪代码:
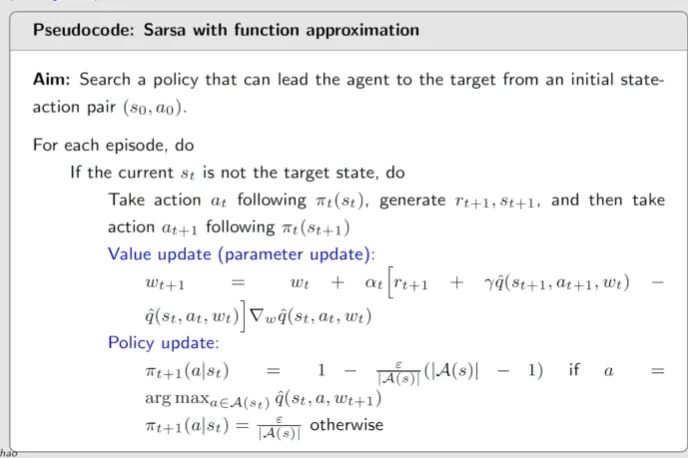
直接先上算法
和上面的Sarsa唯一区别在把
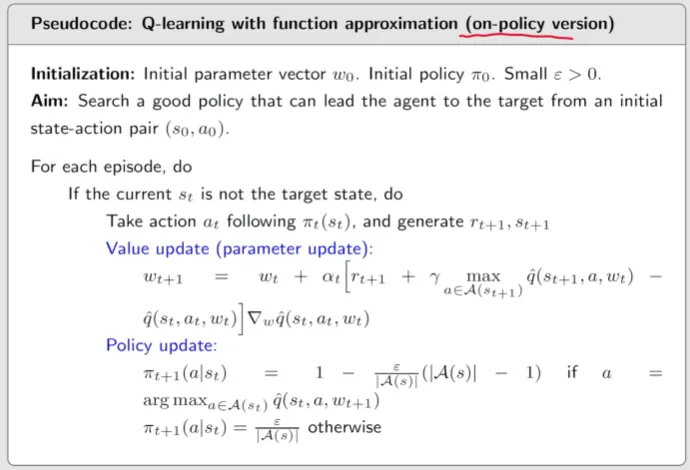
- 神经网络在这里的作用就是一个 nonlinear function
给出DQN的loss/objective function:
where
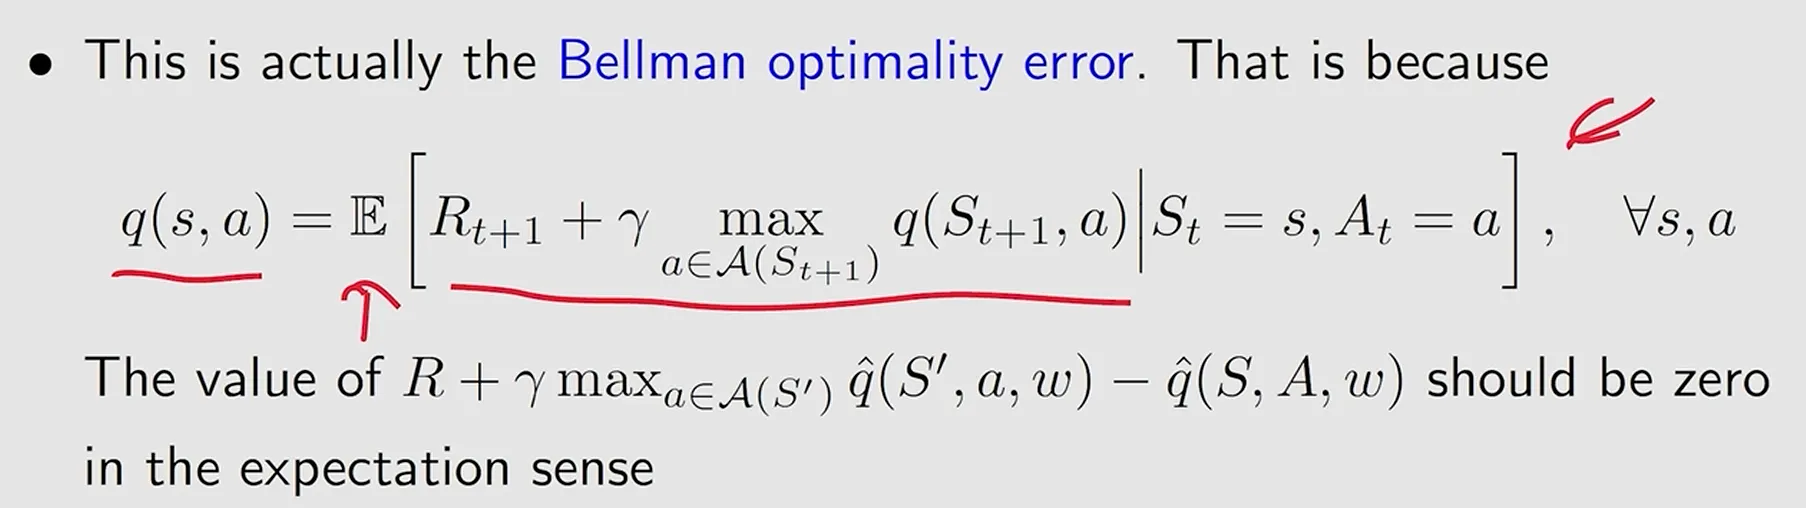
讲一下 DQN 中使用到的两个小技巧:
First technique:
使用了两个 network,a main network and a target network。 因为计算的时候非常复杂,所以计算的时候先固定一个再计算另一个
Another technique:
Experience replay 经验回放
我们按顺序收集完经验后,不一定就要按同样顺序使用这些经验,我们会把经验存储在一个集合里 replay buffer
然后每轮训练我们就可以从replay buffer里拿出一个 mini-batch
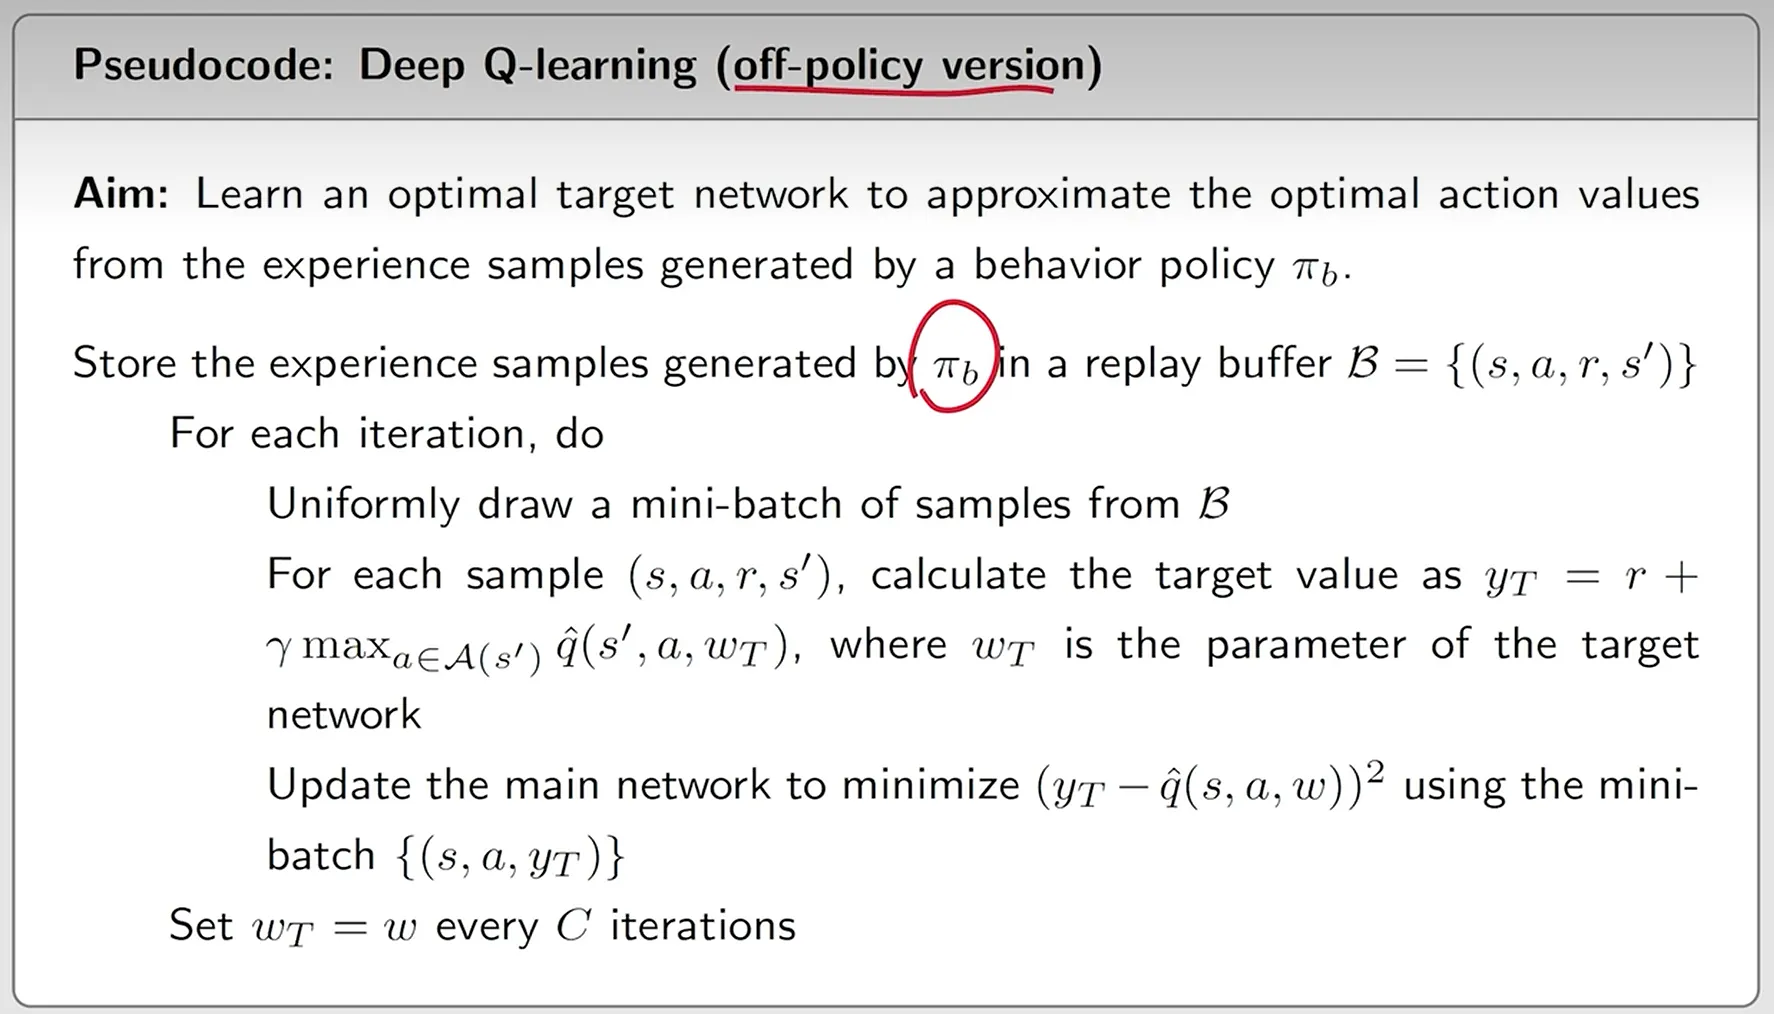
- 把 off-policy 的
产生的samples放入replay buffer - 在每个iteration下:
- 从replay buffer中均匀采出一个 mini-batch
- 对每个sample
,计算 target value , where is the parameter of the target network - 把
全都送到神经网络里去训练,minimize (y_T - \hat q(s,a,w))^2
- 每
个iteration把 更新成
- 在每个iteration下:
注:
- 这里没有policy update,因为这里是off-policy的