Lecture 7: Temporal-Difference Learning
强化学习中的数学原理 | 第七课

依旧要讲一下这一章和前后的关系
第五章的蒙特卡洛法是我们学习的第一个 model free 的方法
这一章的TD Learning是我们学的第二个model free的方法,这是一种迭代式的算法
第六章的随机近似算法是本章的铺垫
本章使用的都是tabular representation,下一章的值函数近似将会是function representation
我非常期待能够实际掌握Q-Learning到底是什么样的
先给出几个例题,看看如何使用RM算法来解决,有助于后面看到TD算法时理解为什么这个算法长这样
Q1: consider the simple mean estimation problem, calculate
based on some iid(independent and identiacally distributed) samples
前面一章一定看到过这个例子,我们把他转换成求解
把
然后就可以用RM的公式来求解
Q2: consider a little more complex problem. Estimate the mean of a function
和上一题非常类似
Q3: 再看一个更复杂的例子: calculate
where
同样的我们从
然后代入RM算法
这个表达式已经和我们之后要看到的TD很像了
Note that:
TD learning可以指一大类的强化学习算法,这一章要讲的所有算法都是TD算法,包括Q-learning- 同时
TD learning也特指我们下面要讲的这种用来估计state values的算法,这是最经典最原始的TD
TD 是一种 model-free 的算法,不需要模型,而要求需要一下数据:
or generated following the policy .
The TD learning algorithm is
where
- 第二个式子的意思就是没访问的
不会改变,只有 的 会变
第一个式子再详细解释一下:
Here, 有几个名字要介绍一下
is called the TD target.
is called the TD error.
总之,新的estimate = 旧的estimate + 修正项
接下来再详细介绍一下
TD target和TD error怎么理解
First, why is TD target ?
首先讲一下,这个算法的作用就是让
还没太懂,先直接看公式
对两边求绝对值,且因为
Therefore,
即证
Second, what is the interpretation of the TD error?
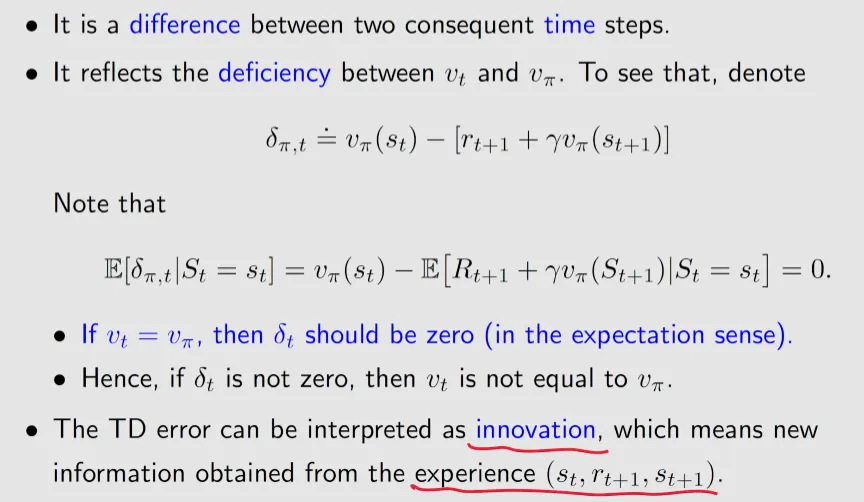
我不知道该怎么表述这段,先这样吧…
其实他是在 solve the Bellman equation of a given policy
首先,我们要给出一个新的贝尔曼公式
where
上面的期望可以拆成
Since
where
这个也是贝尔曼公式,相比之前的更简洁,因为里面没有求和符号
那么,要想求解这个贝尔曼公式,我们就使用RM算法:
发现是不是和前面举的那个例子非常像了,开头的例子简直是这门课里的几个妙手之一
我们同样的也能套进RM算法过程的模版:
因此RM算法最后一步求解的过程就是:
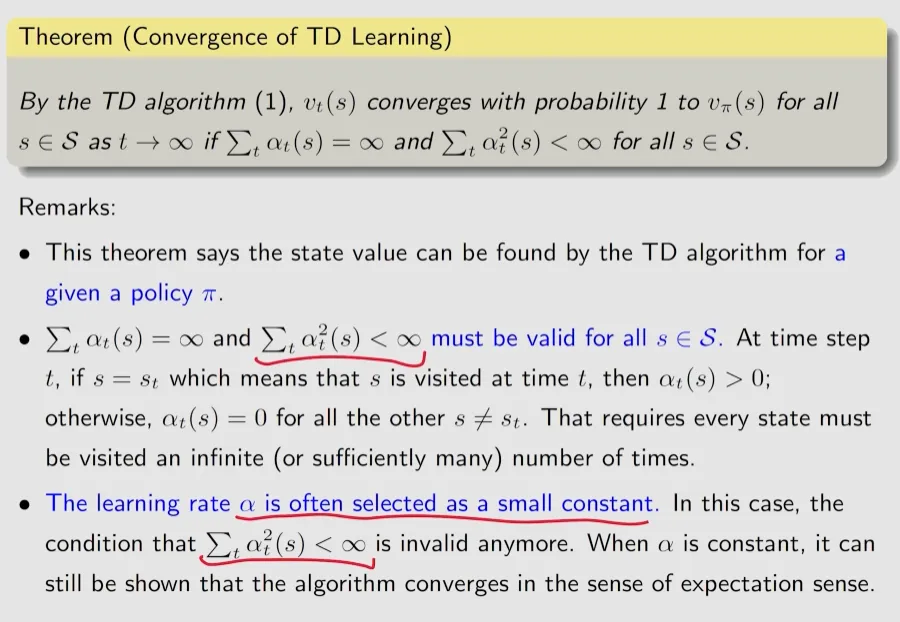
这是一个收敛性证明,我还没有搞太懂
后面讲了一些 TD learning 和 MC learning 的比较,我还没吸收好
- 上一节中的 TD s算法是用来估计一个给定策略的state value的定义是
- 接下来我们要介绍的 Sarsa 可以直接估计 action values
- 我们也会介绍如何使用 Sarsa 来找到最优策略
我们的目标是根据一个给定策略,要把他的action value估计出来
Suppose we hace some experience
我们给出下列 Sarsa 算法,可以用来估计 action values:
where
- 和前面 TD learning 的形式非常像
是 的一个估计 是依赖于 的learning rate
- 这个算法的命名由来:使用到的数据是
- 数学上,和前面的TD learning又类似,Sarsa也是在求解一个贝尔曼公式:
这个贝尔曼公式和之前的不同点在于他是使用action value来表达的,但实际都是一样的,省略一些详细分析
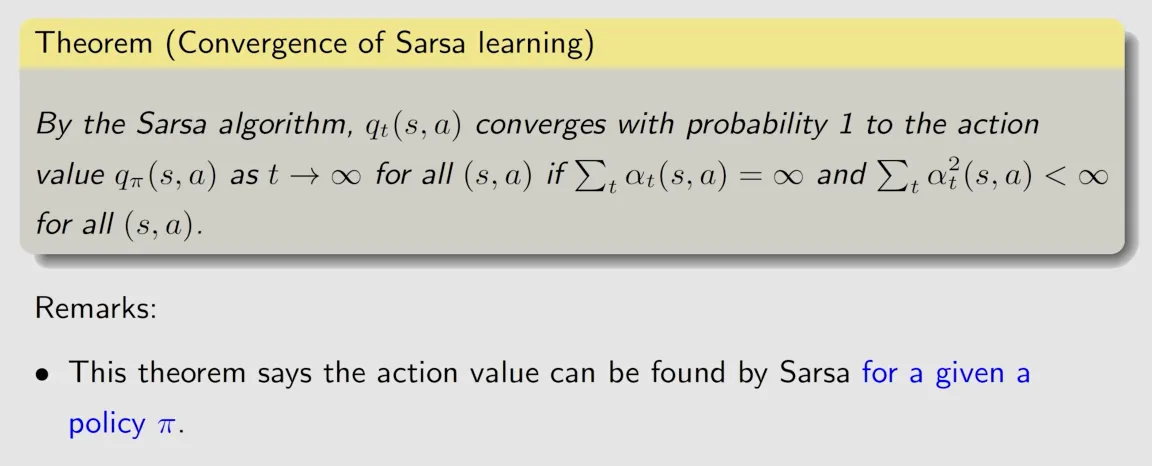
和前面类似也是一个收敛性证明,我暂时也还没搞懂
我们学习的 TD learning 和 Sarsa,是在估计 state value 和 action value,他们是有客观正确值的,但是我们现实中没法真正算出来,所以我们前面讲的算法就是用来估计他们的值
这个定理证明了
流程:
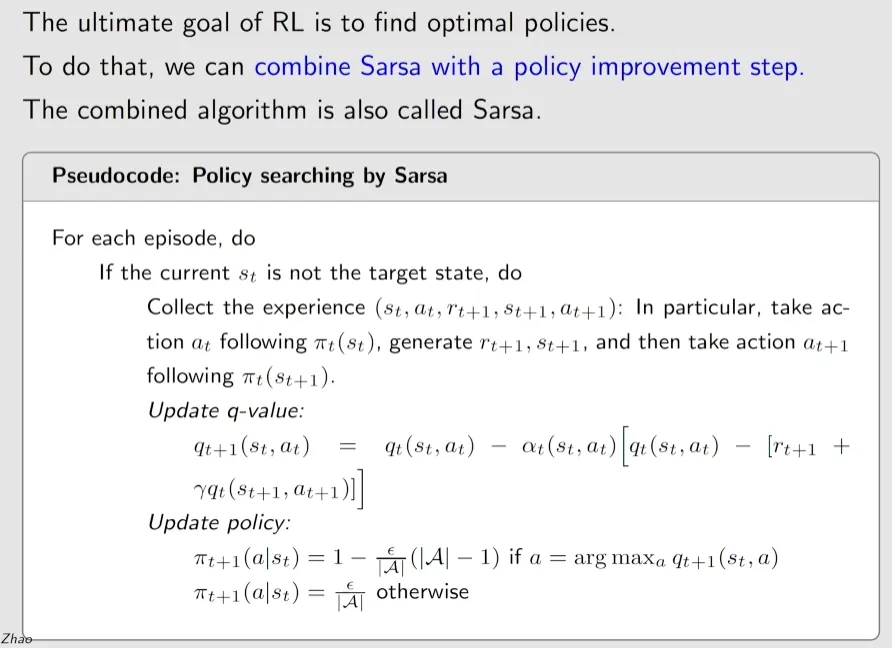
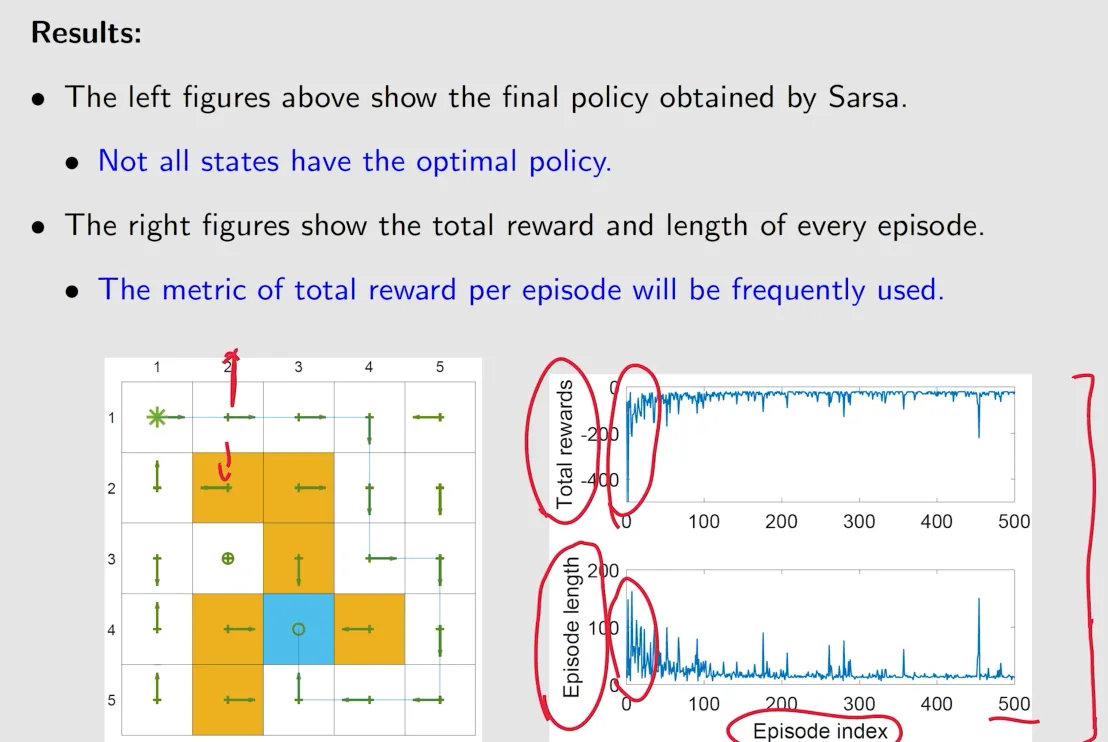
来看一个例子熟悉一下Sarsa吧
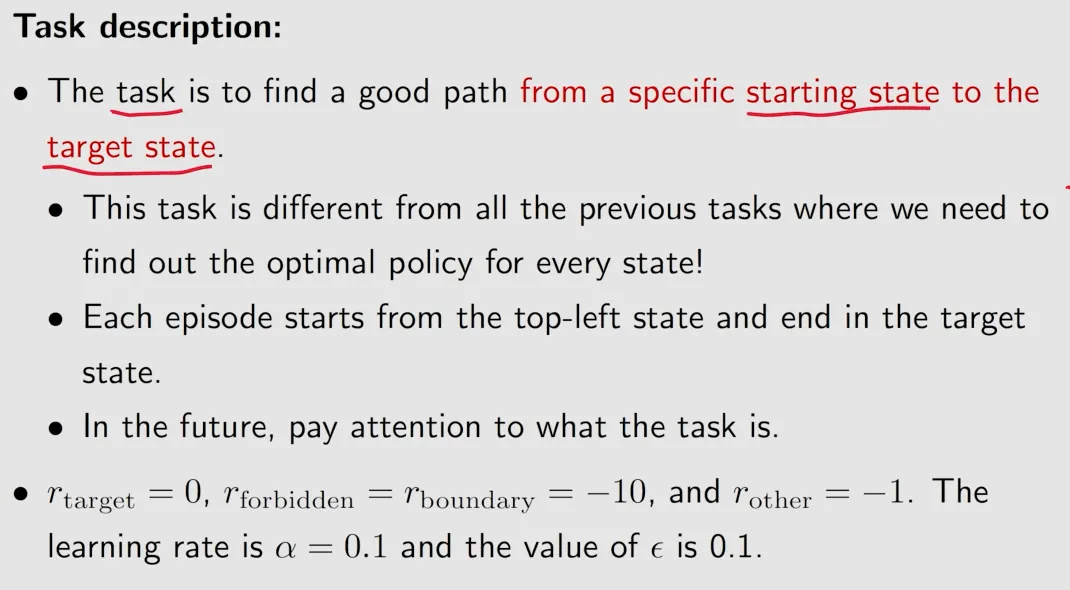
注意这个例子里的任务是:指定起点和目标点,找到最优路径,这和之前的对每一个起点找到到目标点的最优路径是不一样的
接下来是Sarsa的两个变形,我们先跳过,直接看期待已久的 Q-learning,对Q-learning的理解没有影响
同上,跳过
还是要回顾一下Sarsa,Sarsa是用来估计一个给定策略的action value,我们将其与policy improvement的步骤结合就能形成policy evaluation和policy improvement的流程,从而找到 optimal policy
那么Q-learning呢,从数学上,他直接去找optimal action values,所以他不需要做policy evaluation
我其实还没有理解太清楚,先往下看
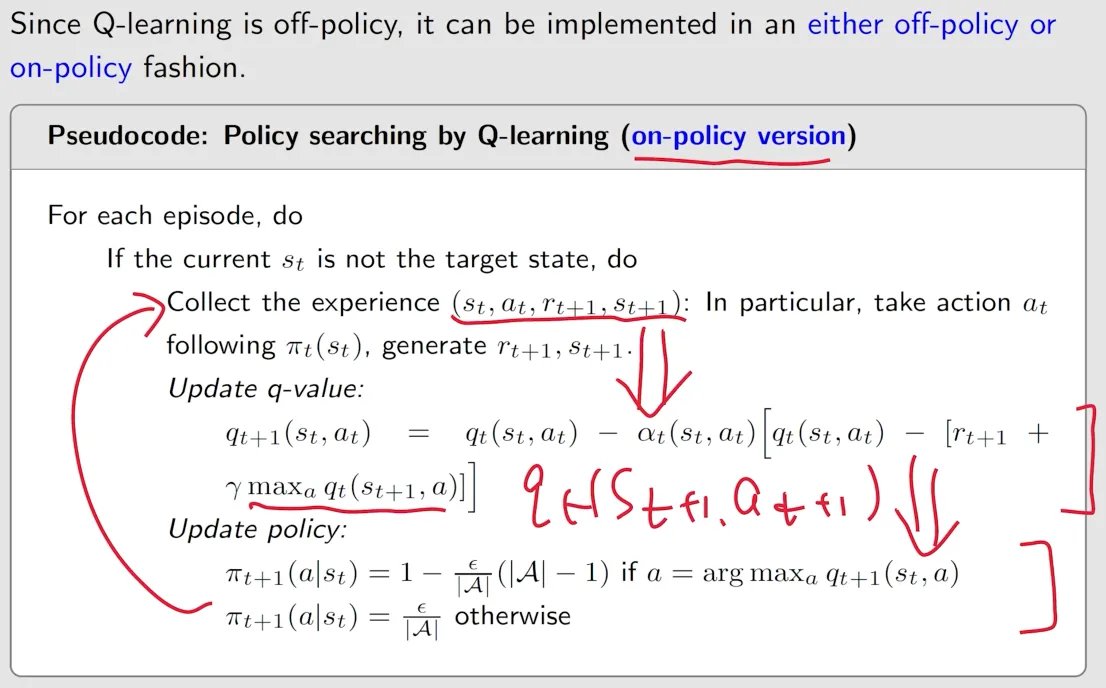
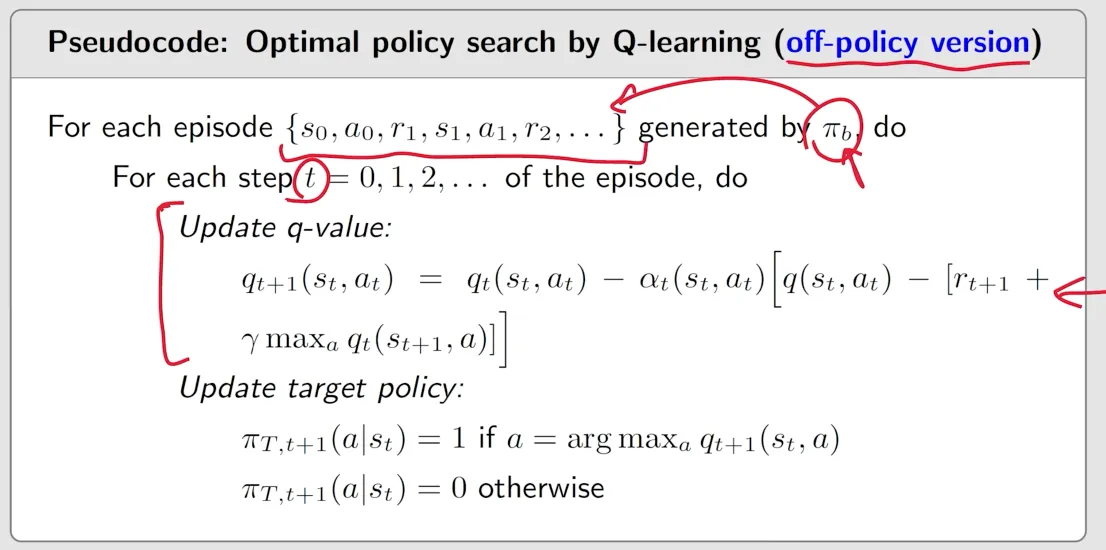
The Q-learning algorithm is
- 结构上和前面的Sarsa很像
- 唯一的不同是TD target变成了
- 之前 Sarsa 的 TD error 是
在数学上,Q-learning不再和前面的 Sarsa 一样是在求解一个贝尔曼方程,而是在解一个贝尔曼最优方程(action value形式),详细证明见书:
借着Q-learning的机会来讲一下 off-policy 和 on-policy
首先要讲一下,在强化学习中有两种“策略”,off/on-policy的区别就在这两个policy之间:
- behavior policy: 这个策略用来和环境进行交互然后生成 experience samples
- target policy: 我们一直更新他,得到我们想要的最优的策略
On-policy vs off-policy
- 当 behavior policy 和 target policy相同时,就是on-policy
- 反之不同就叫 off-policy
如何判断一个算法是on-policy的还是off-policy的?
- First, check what the algoe=rithm does mathematically.
- Second, check what things are required to implement the algorithm.
回顾一下我们之前学的算法是on-policy/off-policy
1. Sarsa: on-policy
- Sarsa 在数学上就是在求解一个给定策略的贝尔曼公式
- Sarsa 的算法是:
which requires
- 如果
给定了,那么 和 (环境返回的奖励和执行 后环境跳转到的下一个状态)不依赖与任何 poilcy(是由 这两个概率决定的,不过我们不知道这两个概率,所以通过采样的方式) 是由给出的 生成的(即我们要用 进行采样,即 是behavior policy) 既是behavior policy又是target policy
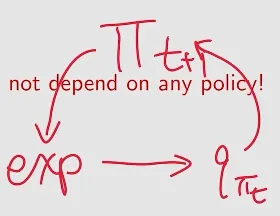
- 首先有一个
- 使用
生成一些experience - 用这些数据去估计
- 再用这个action value去改进
,得到 - 如此循环,因此
既是behavior policy又是target policy
2. MC: on-policy
3. Q-learning: off-policy
- Q-learning 在数学上是在求解一个贝尔曼最优公式,这个公式显式地不含有策略
- Q-learning 算法的公式是:
- 当
给定, 不依赖任何策略 - 所以他的behavior policy实际可以当成任意的,他想要起到探索的作用
- 然后target policy是根据Q 表,使用greedy的思路形成的策略、
- 两个policy不同,所以他是off policy
Q learning 在做的事情是更新我们的q表
更新的顺序是按照智能体从起点开始行动的轨迹,走到哪,离开的那一瞬间就会更新
也因此不会更新到所有状态,只能把从指定起点到目标点的轨迹上的q更新
当然也可以遍历所有点为起点
Q learning 算法的那个计算过程如果看不懂了就让LLM再解释一遍
然后关于他的behavior policy和target policy请看上面off policy里的讲述
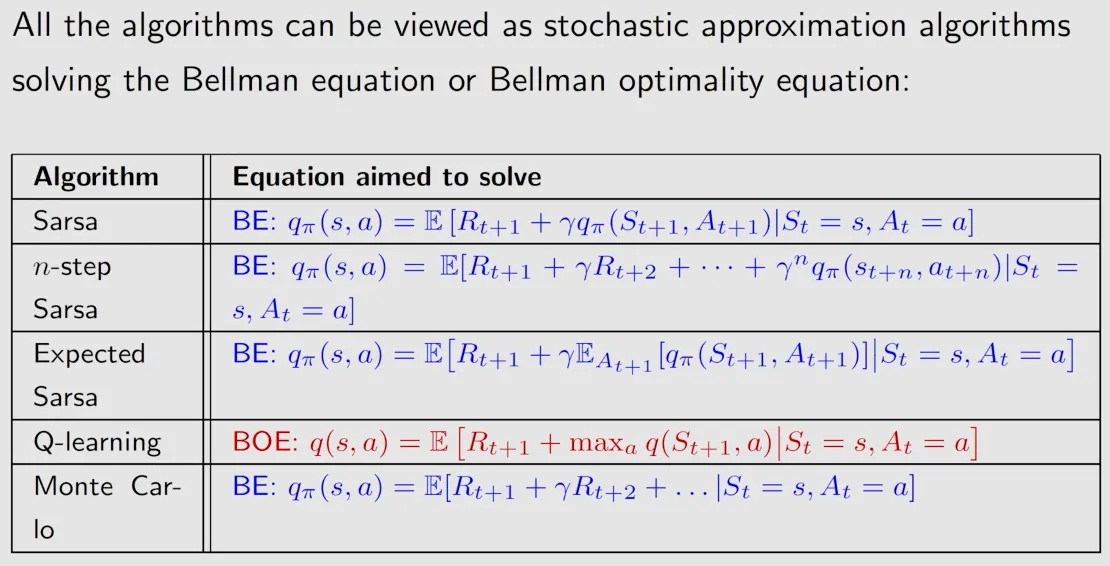
我们前面学的所有TD算法,都可以用一个统一的表达式表达:
where
不同的TD算法其实最大的差别就在于 TD target 不同:
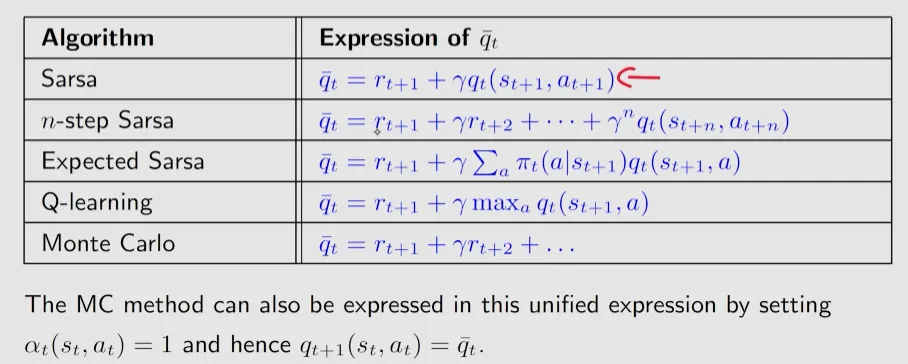
他们在数学上想求解的公式也可以统一起来,基本都是贝尔曼公式或贝尔曼最优公式: