解析 KL 散度
理解 KL 散度及其在 std/opd 中的使用

我之前并没有很好地理解 KL 散度,他的分子分母上是
还是 未能找到好的记忆方式,今天才发现KL散度是从熵和交叉熵这里来的,看过这段数学公式,算是更好地理解了 KL 散度 最后再分析一下在 sft 和 opd 中各自使用的 Forward KL 和 Reverser KL 是何意味
: 交叉熵,其中 是真实分布, 是预测分布 : 熵 - 交叉熵永远大于等于熵
熵:数据来自
交叉熵:数据依旧来自
信息论的直觉来看,一套不对的编码信息
即证:
Jensen 不等式:
是凸函数
令随机变量
则期望
又由琴生不等式:
代入得
记忆方法:
提供分布、产生数据的
对于单个位置
- 如果
真实采样
经常发生的事, 觉得不会发生,这会受到很重的惩罚
- 如果
觉得不重要的地方, 如果多分了概率,不会特别在乎
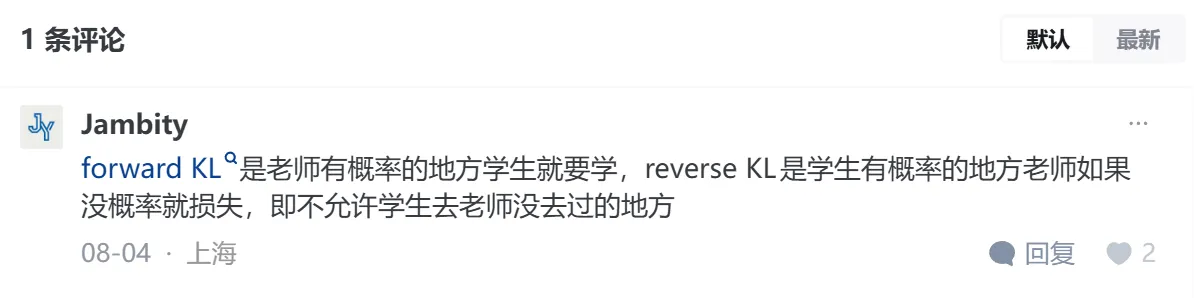
这就是 KL 散度的不对称性(这种不对称性其实也给 KL 散度 恒大于等于 0 提供了直觉)
总之记住,
SFT 中,最小化 SFT 的负对数似然,等价于最小化真实分布
数学特性(Mode-Covering / 模式覆盖):前向 KL 散度会严厉惩罚
但 的情况。这意味着学生模型为了降低损失,会试图覆盖教师模型所有的概率峰值(各种可能的正确回答)。但如果学生模型容量不够,它就会在所有选项上均匀分配概率,导致生成的文本平庸、缺乏自信或出现“幻觉”。
OPD 因为是在学生模型的分布上采样,其典型的目标函数等价于最小化反向 KL 散度:
数学特性(Mode-Seeking / 求模):反向 KL 散度严厉惩罚
但 的情况。这意味着,只要学生模型生成了教师认为概率极低的词(即犯错),就会受到巨大惩罚。相反,只要学生模型专注于教师认可的某一个高质量生成路径,它就能使 Loss 降到极低。这促使模型放弃覆盖所有答案,而是专精于生成自己最擅长且正确的那一种答案。
学生走到过的地方很重要